* 表示共同第一作者;† 表示通讯作者
Any Time, Any Space: A World-State-Centric Framework for Agentic Video Generation ICLR 2027 在审
[arXiv] [代码] [项目页] [Hugging Face 当日论文第 2]
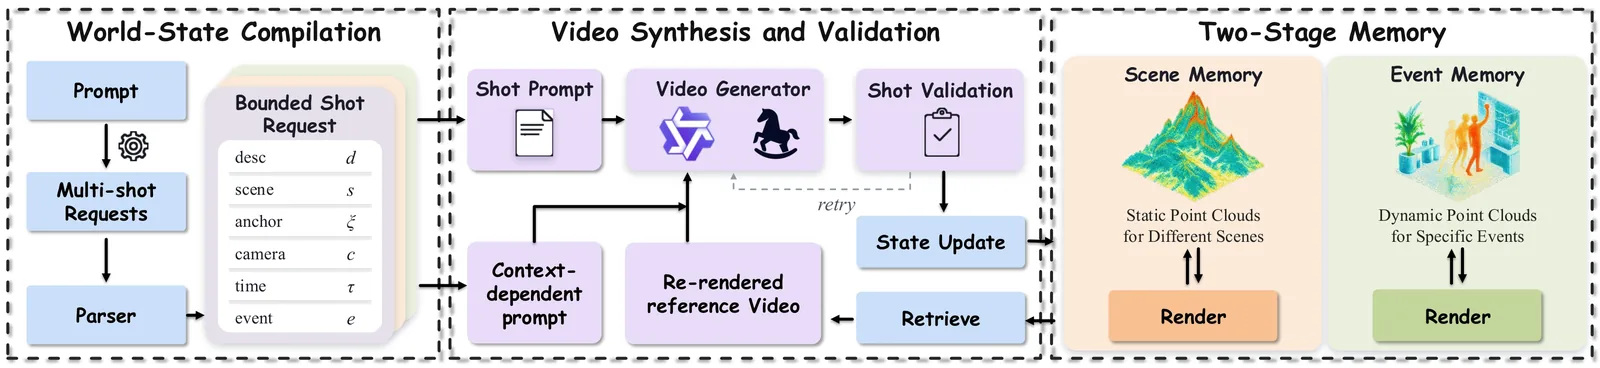
- 问题:长片按剧本分镜生成时,镜头之间并不连续——隔几个镜头回到同一个场景,或换个机位重放之前发生的事。只在镜头之间传提示词或最近几帧,既没有共享的空间坐标,也没有按时间索引的事件记录,回访时场景和事件都会走样。
- 做法:ATAS 把剧本编译成带有地点、机位和事件时间引用的镜头请求。生成前,从场景记忆(配准后的静态几何)和事件记忆(按场景、事件、时间索引的动态观测)中取出相关证据作为条件;生成后重建并配准新片段,只有通过审核和状态检查才写回记忆,成片交付不受记忆写入影响。
- 结果:在四个视频生成器上,全部跨镜头一致性指标都有提升,每个基座的综合分都最高;空间回访超过对比的智能体和 3D 引导方法,三项事件重现指标领先,人工评测六项全部第一。
- 我的工作:共同第一作者,负责代码编写、实验数据和 demo 设计。