关于我

我是李业,浙江大学软件工程专业 2023 级本科生,研究视频生成与世界模型。我关心的问题是:怎样让视频生成模型像一个持续存在的世界那样工作——镜头切走再切回来,场景和人物还在原处;物体下落、碰撞,过程合乎物理。

作为共同第一作者,我完成了 ATAS——为多镜头视频生成维护可检索的场景记忆与事件记忆,获 Hugging Face Daily Papers 当日第 2 名;以及 UniRLM——把图文交错生成的长上下文拆成只带直接依赖的短调用。作为学生二作(代码实验主力)共同完成了 ReCA(把几分钟的长视频生成看作上下文分配问题)和 Gen-RSI(借助 Blender 物理仿真修正生成结果,再蒸馏回视频生成器)。

动态

研究项目

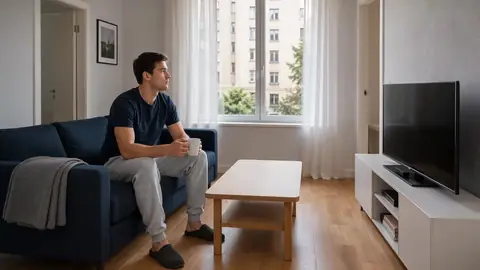
ATAS 生成短片中的一个镜头:客厅沙发上端着杯子的男人

arXiv 2026 · ICLR 2027 在审共同第一作者Hugging Face Daily Papers 当日第 2

Any Time, Any Space: A World-State-Centric Framework for Agentic Video Generation

以世界状态为中心的智能体视频生成

Weijie Wang*, Haomin Zhang*, Ye Li*, Akide Liu, Zeyu Zhang, Haoyu Zhao, Yefei He, Donny Y. Chen, Feng Chen, Bohan Zhuang†

为多镜头视频生成维护场景记忆与事件记忆:回到旧场景、换机位重放旧事件时,先取出相关状态作为条件,生成后经检查再写回。在四个视频生成器上提升了全部跨镜头一致性指标,人工评测六项第一。
AAAI 2027 在审共同第一作者

UniRLM: Recursive Unified State Modeling for Interleaved Generation

面向图文交错生成的递归统一状态建模

长篇图文交错生成越往后越崩,症结在图像生成只在一两张图的短上下文上训练过。UniRLM 免训练地把长上下文轨迹拆成子任务 DAG:每次调用只带入直接依赖的图像,校验通过才写回,独立节点并行执行。

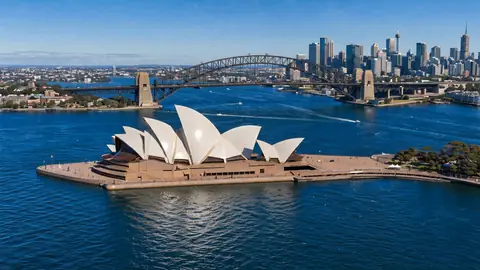
ReCA 展示视频中的一帧:航拍悉尼歌剧院与海港大桥

arXiv 2026 · 预印本

ReCA: Multi-Shot Long Video Extrapolation via Recursive Context Allocation

通过递归上下文分配实现多镜头长视频外推

Akide Liu, Jinbo Xing, Chaojie Mao, Ye Li, Zeyu Zhang, Yefei He, Weijie Wang, Zihan Wang, Yu Liu, Gholamreza Haffari, Bohan Zhuang

把一帧画面续写成几分钟、有镜头结构的长视频。ReCA 认为瓶颈在上下文分配而非长度:递归拆成上下文有界的子问题,只在叶子节点调用短视频模型,多镜头一致性指标提升 28–43%。