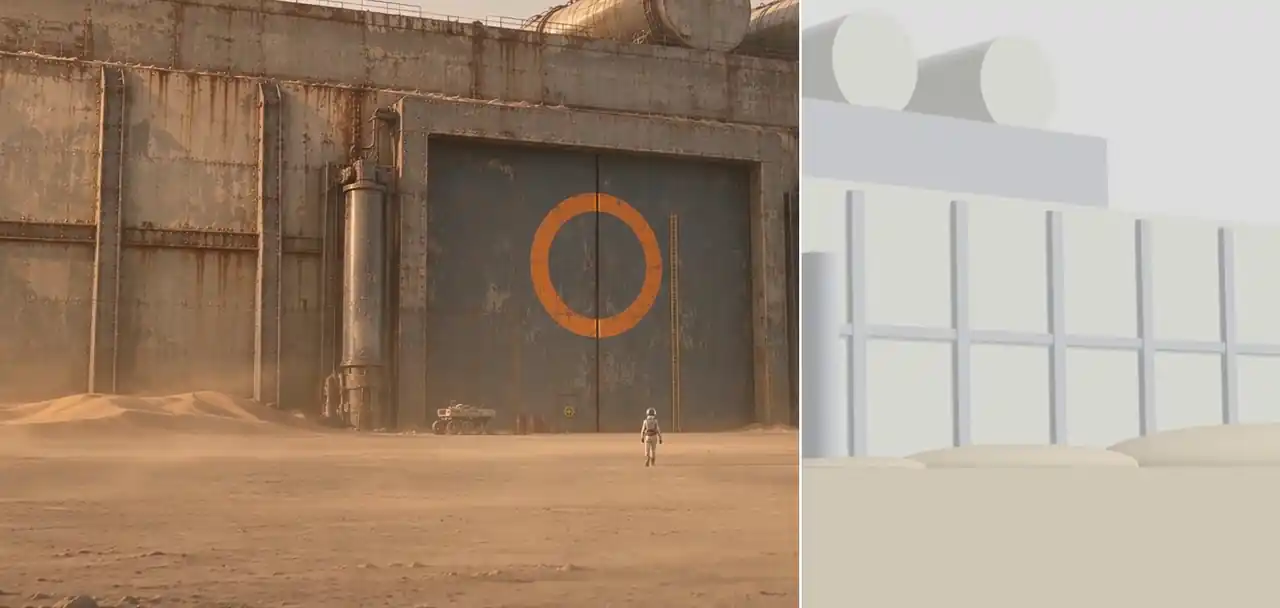
我一边配合着 Claude 做这个 skill,一边写下了这篇东西。这篇博客是我在完成这个产品的同时写的一些感想。
先交代这个项目。它叫 film-director,是一组给写代码的 agent(Claude Code、Codex,以及其他认 SKILL.md 的 agent)用的 skill 和插件。agent 拿到剧本,像导演一样拍一部短片:先排镜头,空间容易错的戏先在 Blender 里搭白模,再用现成的视频模型一段段生成、检查,最后剪成片。我自己用的是 Claude Code(Opus 5.5 xhigh)+ gpt-image 2.6 + Wan 3.0,二维动画用过 Seedance 2.5,全程自动。
这个 skill 的目的,是让人高效地做出高质量的 AI 电影。举个简单的例子:我一次性跑了 6 个 1 分钟的片子,3 个基本看不出奇怪的切换,3 个有小问题;那 3 个,我看完指出问题,Claude 重抽一次自己就修好了。人只要看片、提意见,剩下的交给 agent,这就是这个 skill 想做到的样子。
仓库在 https://github.com/memoryoffish/film-director-skill-plugin,展示页在 https://memoryoffish.github.io/film-director-page/。
宣传片《电影导演 Claude》,3 分 03 秒:Claude 拿到这份 skill,当导演拍了四部短片《雨夜》《第一口》《月亮掉下来了》《两张照片》,画面都出自真实运行。
为什么做这个 skill
首先,我觉得这是我的 engineering 工作,不是 research 工作。激发我做它的,是我对 research 提出了一些问题、却又没法优雅解决的那份不甘。
说真的,我不是说 research 做得不好,只是觉得 research 的场景还是太单一了:针对某一个点钻得太深,反而忽略了整体的真实成片质量。这是工业界和学术界常见的隔阂。
因而,我想做一个开箱即用的高质量产品,从工程上把这个问题解决掉。
我理解的 agentic code world model
我的研究方向是 agent 驱动的 code world model:由 coding agent 用代码维护持续存在的世界状态、推演事件和物理,再交给视频模型渲染成画面(做过的几个工作在研究项目里)。
放到拍片上,最直接的做法就是让 agent 先在 Blender 里搭白模,把谁在哪、朝哪、机位在哪算清楚,再交给视频模型去画,这个 skill 现在也是这么做的。但我一直在想一个问题:
proxy(白模这类代替真实场景的粗几何)是否真能达到 code world model 里说的重要地位呢?我个人觉得,目前的视频模型在 training free 的情况下,很难适配 proxy。B 站有个视频很能说明白模的许多缺陷:https://www.bilibili.com/video/BV1aTWm6jEqW/。当然我知道会有人来喷这个观点,不过我觉得可以深入探讨。我对未来的判断是:现在是先用 Blender 搭好世界,再交给视频生成模型去渲染;以后会变成先用游戏引擎把世界跑起来,再交给视频生成模型去渲染。我组里就有师兄在做这方面的内容,欢迎来我们组里讨论。
怎么落地
做这个 skill,我在意三件事:便捷性、有效性、高质量。
- 便捷性: 快速装进 agent,让 agent 马上能用,而不是一条复杂的 pipeline。那种 pipeline 不仅冗余,也没发挥出 harness 最本真的能力。
- 有效性: 不把无用的东西放进来。我认为 AI 视频要成为电影,最重要的几个部分是:切镜(这是失去 AI 感、获得艺术感最重要的方式)、剧本构造、视频模型的 input engineering、剪辑。
- 高质量: 不出特别烂的成片(视频基模能力不行的除外)。我追求的是把视频基模的能力用出 90%(100% 得靠用 AI 做片的大师级剪辑师亲自上手,有时候还要靠运气),这也是我对一个项目的追求。
这个 skill 好在哪里:实在的全自动化,以及高贵的艺术感
我觉得目前的很多 skill,其实都没法做到全自动地产出很好的内容。用这个 skill,开头那套组合就能全自动地拍完一部片;有小问题的,我看完提出来,Claude 重抽一次自己就能修好。
我做了一个展示页,放了 27 部短片,全是自动生成的。我还和目前仍在更新且非常火热的两个 AI video pipeline 和 skill 进行了比较。之后我也会放上一些 human in the loop 的例子:全自动生成的视频,人看完提出问题,Claude 是怎么快速修好的。最后的费用我也会一起列出来。
在这个 skill 里,你不会看到 AI 短剧那种非常 AI 的感觉,而是一种拍摄的真实感、艺术感,我也会用展示页把它表现出来。这也是我做 AI 自动化生成一直在追求的东西。
我对几个视频模型的看法
其实吧,我觉得目前最累的一点,是首帧模式不能带其他参考图。如果可以带,一大半问题都能解决,人物一致性也会轻松很多。现在的 skill 在一致性上还是有问题,这里面是个 tradeoff:
- 首帧 / 首尾帧(fl2v) 不能用参考图,但很听首帧的话。可这样一来,之后镜头里新出现的人物可能会变;而单镜外推的时候,首帧遵循度又非常关键。
- ref2v(参考图) 能用参考图,但完成不了单镜外推的任务,只能在切镜的时候用。
- 两者有机结合能解决很多问题,但解决不了所有;而且首帧模式生成出来的质量,就是更好。
所以我只能在镜头表里按镜头选喂法,一致性这块尽量靠参考图,不靠文字。
再说说 HappyHorse、Wan、Seedance,这是我用下来的感觉:
- HappyHorse(1.1): 动作片效果不错,但一些正常的家庭场景很不好。我拍过两部,看片的结论是不如另外两家。
- Wan(3.0): 正常场景和黑白动画很不错,粘土等动漫场景也好;打斗和科幻一般。可以说除了打斗和科幻,都比较全能。
- Seedance: 2.0 用下来很好,2.5 整体都挺不错,白模遵循度也是最高的。
共同弱点:科幻太容易起褶皱,人脸生成也起褶皱。
skill 的意义、价值和遗憾
先说我为什么认为 skill 是承载这件事最好的形式。基模的能力已经够强了,你只要告诉它需要做什么,它就能完成;好的 skill 应该只是告诉基模干什么。在这个 agent 时代,浓缩的 skill 反而才是最大的精华,就像一篇论文,其实核心就是 abstract 加一个 problem insight。film-director 也是这么分的:核心是一个 skill(拍片流程、Blender 白模、挑音效三部分),装上就能把片拍完;plugin 是可选的,给想看每一镜、想接进 ComfyUI 的人用。
可惜的是,目前 skill 和 plugin 很难立稳脚跟。没有哪家公司推出的产品,是只有一个 skill 的,都是 harness 加上一些 plugin 和 skill。我觉得原因有不少,说三点:
- skill 的不确定性太大,没人愿意买单。 同时 skill 太轻量,体现不出工程量。但说真的,最便捷、最实用的就是 skill。
- 之前营销的 skill,过度消费了人们对 skill 的热情。 skill 过于简单,效果又难以定义,于是有人仗着 skill 的好坏不好衡量,生产出一堆无用的 skill。这些垃圾毋庸置疑,把 skill 的作用拉低了。
- RSI harness 出来了。 大家的目光都被 harness 吸走了,skill 就更难被看见。但是,对个人来说,skill 装上就能用,RSI harness 却是一整套重系统。
还没做好的,和期待
我想改进的有这几处:
- 白模和切镜还没有完全有机融合。 现在做得好,主要是镜头表(shot-list)在发力。物理检测,以及一些特别有意思的场景切换,还比较少。
- 关键帧的一些设计也不够好。
- 各种模型的适配经验文档,还是相对较少,期待之后继续加入。
- 和 ComfyUI 的协作性一般。 现在只能回放,人在 ComfyUI 里改了提示词点运行,不会重新生成,要调整还得告诉 agent。
瑕疵当然是有的,毕竟视频模型还没到什么都不错的那一档。我希望这个 skill 能让大家一起进一步探索 AI 电影,来探讨怎样让 agent video gen 做得更好。
- 仓库:https://github.com/memoryoffish/film-director-skill-plugin
- 展示页:https://memoryoffish.github.io/film-director-page/
宣传片里的音效。 下面这几段录音经过剪辑、混音后用在宣传片里;其余的声音是视频模型生成的成片原声,旁白用 Qwen3-TTS(Apache-2.0)合成。
- 《雨夜》:“Rain on Windows, Interior, A.wav” by InspectorJ — https://freesound.org/people/InspectorJ/sounds/346642/ — CC BY 4.0
- 《第一口》:“fizzing” by odilonmarcenaro — https://freesound.org/people/odilonmarcenaro/sounds/238564/ — CC BY 4.0
- 《月亮掉下来了》:“Night time crickets call” by Clearwavsound — https://freesound.org/people/Clearwavsound/sounds/523439/ — CC BY 3.0
本项目与 Anthropic 无关,非 Anthropic 官方项目。Claude 是 Anthropic 的商标。