ATAS:以世界状态为中心的智能体视频生成
Any Time, Any Space: A World-State-Centric Framework for Agentic Video Generation
共同第一作者。
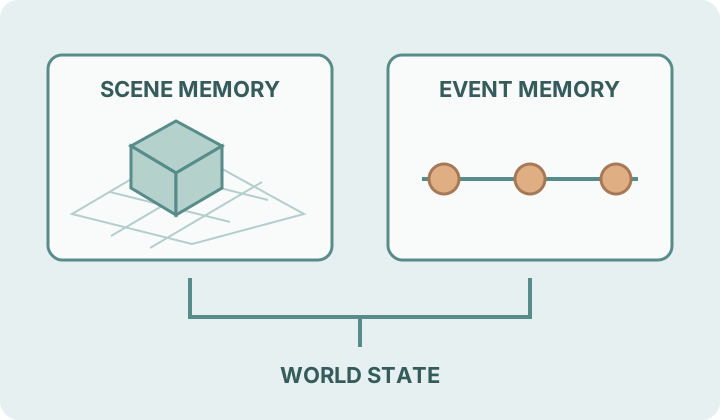
ATAS 使用持久世界状态组织多镜头视频生成:场景记忆记录共享坐标系中的几何信息,事件记忆支持按场景、事件和时间检索。在返回旧场景或从新视角重现既有事件时,系统检索相关状态,并在验证后更新记忆,以保持时空一致性。
ReCA:通过递归上下文分配实现多镜头长视频外推
预印本 · 2026
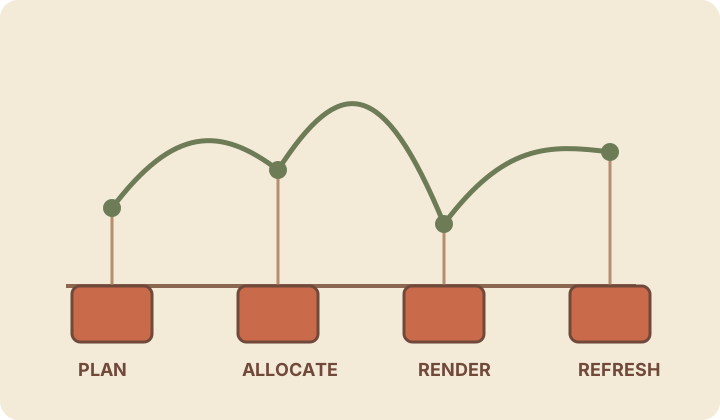
在有限的短视频生成预算下,递归组织镜头规划、上下文分配与状态更新,将已有画面延续为多镜头长视频。
我负责递归规划与上下文分配模块的代码实现与实验。
Gen-RSI:视频生成模型的递归自改进
Gen-RSI: Recursive Self-Improvement of Video Generators through World Proxies
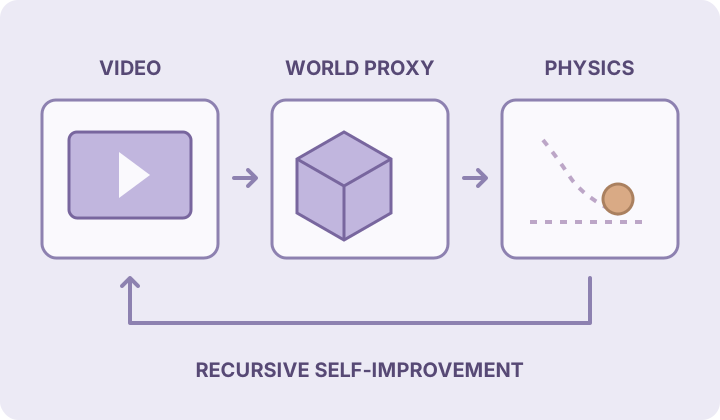
Gen-RSI 将生成视频转化为可执行的 Blender 代理,通过物理仿真修正代理,再用渲染结果引导教师模型,在学生自身的去噪状态上训练视频生成器,以改进物理一致性。
我参与后训练实现与实验。